

唉其实每一个比赛都需要花费很大的精力啊,最后一天快一天没吃饭,两天就睡俩小时。即便这样其实时间也不太够用了,论文只用了不到一天的时间,虽然完成度还可以,但我总觉得还有相当多的地方没有打磨润色,只能希望结果能稍微好一点吧。
这几天蹬疯了,gpt三张重置卡跟流水一下哗啦啦流走了,三天蹬了不知道几亿token,效果也一般,哪怕是幻神Astra。也许是prompt的问题,Astra开goal只能跑到250s的基准,听说有人一口气能跑到200s,真不知道怎么优化的。当然,人工干预一些决策的走向与进行,我们能做到优化到230s,小样本情况甚至能到220s。可惜抽奖的时候签运并不是很好。都怪ljz(
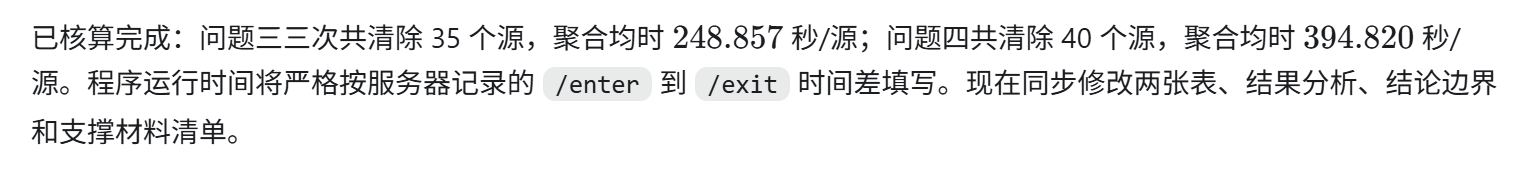
反倒是Q4表现还很不错,总体来说还不错吧。
哎其实本来以为Astra能够给我带来很大的惊艳,哪知也只能说是中规中矩。想了一下,其实可能是讨论层次太少了。但一开始采用的模式是先与gpt讨论方案,直到完善后采才去验证。然而这样的效果还不如Astra max开个goal模式跑出来的结果好,有点道心破碎,就交给了Astra自己跑。后来花了一百多开了个pro,蹬上Astra,结果充其量只能继续优化2s左右。
其实AI跑这种课题的模式很简单,就是找出目前最可行的方案集,然后写代码验证,期间安全措施和测试等等做了一大堆,因而一次迭代需要耗费不少时间成本,但换来的收益却是微小的。AI提出的方案并没有通过收益估计,哪怕是人也很难看出收益如何。而到后面就只会做一些微调了,没办法作出比较激进的改变。本质上是对方案组合的枚举与验证,我唯一做出的一个比较有效的改动也并不难以想出,但与ai当时投入的方向不同,方向改变跨度也比较大。因而AI能不能创造出新的东西呢?也许能也许不能。目前ai在数学界的成就几乎都是靠的反例证伪或者方程解验证这些方法,很难看见通过正面的推导证实一些猜想。目前的迭代主要针对目标的实现和完成,但是如果针对样本较少的宽泛的目标,ai的搜索空间是比较大的,因而也比较难以完成。
至于ds,我想推翻之前的话,它大概也许是个蠢货。其实有一个很有趣的事实,oa在进行研究时让几千个gpt并行,同时在消息板上共享想法(嗯并行搜索同时抽象汇总确实能提升速度和质量)。于是我尝试了一个小demo,跑了10-20个ds来跑C题,并给了消息板交流。结果跑了半天只能跑到300s,无奈将250s的部分方案补充上去。花了我10mtoken之后我再来看,很棒!baseline一动不动!ds在干嘛?它tmd居然还在验证我给的方案是否正确?而且验了不止一次,这个验完那个验,验完一遍在质疑一遍,甚至认为 “不可能低于240s”。于是我给了正确性证明,给了230sbase line方案的完整版本,它们乖乖的验证完之后惊呼
“我们之前的结论是错的!230s确实是可以达到的!”
我操
你个吃白饭的大肥鱼
最后靠着雷霆调参调了5s,除此之外仍有质疑方案,最后我结束了这个毫无意义的实验,花了我百来块钱毫无收获(其实是因为一开始子agent全用的v4pro)。
你个吃白饭的大肥鱼
不得不说ds4.1flash确实是有点毛病,包括我尝试调试的一个能够进行自进化的harness里,接入4.1flash后很容易进入逻辑死循环,而在这还不成熟的时候v4flash是没有出现类似情况的(也有可能迭代出问题了)。它们的推理总是倾向于自我改变或者怀疑而不是尝试找外部条件的问题与尝试突破
就这样吧,其实没什么笔墨了
晚安
Comments | NOTHING